副标题#e#
利用了O/R Mapping东西的典范J2EE应用城市面对这样一个问题:如何通过最精简的SQL查询获取所需的数据。许多时候这可不是垂手可得的工作。默认环境下,O/R Mapping东西会按需加载数据,除非你改变了其默认配置。延迟加载行为担保了依赖的数据只有在真正请求时才会被加载进来,这样就可以制止建设无谓的工具。有时我们的业务并不会利用到依赖的那些组件,这时延迟加载就派上用场了,同时也无需加载那些用不上的组件了。
典范环境下,我们的业务很清楚需要哪些数据。但由于利用了延迟加载,在执行大量Select查询时数据库的机能会低落,因为业务所需的数据并不是一下子得到的。这样,对付那些需要支持大量请求的应用来说大概会发生瓶颈(可伸缩性问题)。
来看个例子吧,假设某个业务流程想要获得一个Person及其Address信息。我们将Address组件设置成延迟加载,这样要想获得所需的数据就需要更多的SQL查询,也就是说首先查询Person,然后再查询Address。这增加了数据库与应用之间的通信本钱。办理步伐就是在一个单独的查询中将 Person和Address都获得,因为我们知道这两个组件都是业务流程所需的。
假如在DAO/Repository及底层Service开拓特定于业务的Fetching-API,对付那些拥有差异数据集的沟通规模工具来说,我们就得编写差异的API举办抓取并组装了。这么做会使Repository及底层Service过于膨胀,最终酿成维护的梦魇。
延迟抓取的另一个问题就是在获取到请求的数据前要一直打开数据库毗连,不然应用就会抛出一个延迟加载异常。
说明:假如在查询中利用预先抓取来获取二级缓存中的数据时,我们将无法办理上面提出的问题。对付Hibernate来说,假如我们利用预先抓取来获取二级缓存中的数据,那么它将从数据库而不是缓存中去获取数据,哪怕是二级缓存中已经存在该数据。这就说明Hibernate也没有办理这个问题,从而表白我们不该该在查询中通过预先抓取来得到二级缓存中的工具。
对付那些可以让我们调理查询以获取缓存工具的O/R Mapping东西来说,假如缓存中有工具就会从缓存中获取,不然采纳预先抓取的方法。这就办理了上面提到的事务/DB毗连问题,因为在查询的执行进程中会同时获取缓存中的数据而不是按需读取(也就是延迟加载)。
通过下面的示例代码来相识一下延迟加载所面临的问题及办理步伐。思量如下场景:某规模中有3个实体,别离是Employee、Department及Dependent。
这三个实体之间的干系如下:
Employee有0或多个dependents。
Department有0或多个employees。
Employee属于0或1个department。
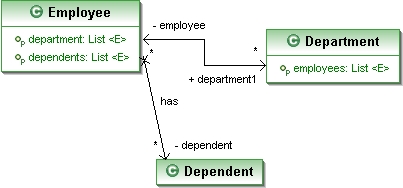
我们要执行三个操纵:
获取employee的具体信息。
获取employee及其dependent的具体信息。
获取employee及其department的具体信息。
#p#副标题#e#
以上三个操纵需要获取并泛起差异的数据。利用延迟加载有如下漏洞:
假如对实体employee所关联的dependent和department这两个实体利用延迟加载,那么在操纵2和3中就会生成更多的SQL查询语句。
在多个查询语句的执行进程中需要保持数据库毗连,不然会抛出一个延迟加载异常,这将导致数据呈现问题。
但另一方面,利用预先抓取也存在如下漏洞:
对employee所对应的dependents和department采纳预先抓取会发生不须要的数据。
无法在特定的场景下对查询举办调优。
在Repository/DAO或底层处事中利用特定于操纵的API可以办理上述问题,但却会导致如下问题:
代码膨胀——不管是Service照旧Repository/DAO类都无法幸免。
维护的梦魇——不管是Service照旧Repository/DAO层,只要有新的操纵都需要增加新的API。
代码反复——有时底层处事需要在获取的实体上增加某些业务逻辑,与之雷同,还要在数据返回前查抄DAO/Repository层的查询响应以验证数据可用性。
为了办理上面这些问题,Repository/DAO层需要按照差异的业务环境执行差异的查询来获取实体。就像Aspect类所界说的那样,我们可以按照特定的操纵利用差异的抓取机制来包围Repository/DAO类所界说的默认抓取模式。所有的抓取模式类都实现了沟通的接口。
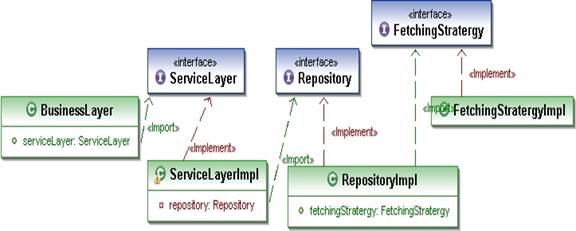
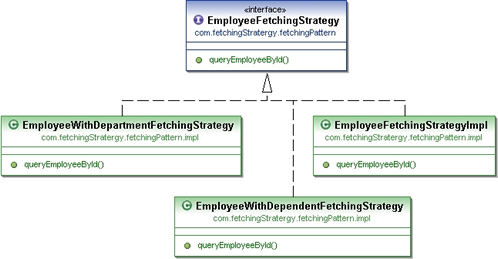
Repository类利用了上述的抓取模式来执行查询,如下代码所示:
#p#分页标题#e#
public Employee findEmployeeById(int employeeId) {

 List employee = hibernateTemplate.find(fetchingStrategy.queryEmployeeById(),

 new  Integer(employeeId));

 if(employee.size() == 0)

 return null;

 return (Employee)employee.get(0);

}
Repository类中的employee的抓取计策需要按照实际环境举办调解。我们抉择将Repository层的抓取计策调解到 Repository和Service层外,放在一个Aspect类中,这样当需要增加新的业务逻辑时只需修改Aspect类并增加一个针对付 Repository的抓取计策实现即可。这里我们利用了面向方面的编程(Aspect Oriented Programming)以按照业务的差异利用差异的抓取计策。
什么是面向方面的编程?
面向方面的编程(AOP)可以通过模块化的形式实现实际应用中的横切存眷点,如日志、追踪、动态阐明、错误处理惩罚、处事程度协议、计策加强、池化、缓存、并发节制、安详、事务打点以及业务法则等等。对这些存眷点的传统实现方法需要我们将这些实现融合到模块的焦点存眷点中。凭借AOP,我们可以在一个叫做方面(aspect)的独立模块中实现这些存眷点。模块化的功效就是设计简化、易于领略、质量晋升、开拓时间低落以及对系统需求改观的快速响应。
接下来读者伴侣们可以参考 Ramnivas Laddad所著的《AspectJ in Action》一书以具体相识AspectJ的观念以及编程方法,还可以相识一下AspectJ的开拓东西。
Aspect在抓取计策实现上饰演着重要脚色。抓取计策是个业务层的横切存眷点,它会跟着业务的变革而变革。Aspect对付特定的业务逻辑下利用何种抓取计策起到了至关重要的浸染。这里我们将对抓取计策的打点放在了底层处事和Respository层之外。任何新的业务都大概需要差异的抓取计策,这样我们就无需修改底层处事或是Respository层的API就能应用新的抓取计策了。
FetchingStrategyAspect.aj
/**

   Identify the getEmployeeWithDepartmentDetails flow where you need to change the fetching

   strategy at repository level

*/

pointcut empWithDepartmentDetail(): call(* EmployeeRepository.findEmployeeById(int))

&& cflow(execution(* EmployeeDetailsService.getEmployeeWithDepartmentDetails(int)));
/**
When you are at the specified poincut before continuing further update the fetchingStrategy in
EmployeeRepositoryImpl to EmployeeWithDepartmentFetchingStrategy
*/
before(EmployeeRepositoryImpl r): empWithDepartmentDetail() && target(r) {
r.fetchingStrategy = new EmployeeWithDepartmentFetchingStrategy();
}
/**
Identify the getEmployeeWithDependentDetails flow where you need to change the fetching
staratergy at repository level
*/
pointcut empWithDependentDetail(): call(* EmployeeRepository.findEmployeeById(int))
&& cflow(execution(* EmployeeDetailsService.getEmployeeWithDependentDetails(int)));
/**
When you are at the specified poincut before continuing further update the fetchingStrategy in
EmployeeRepositoryImpl to EmployeeWithDependentFetchingStrategy
*/
before(EmployeeRepositoryImpl r): empWithDependentDetail() && target(r) {
r.fetchingStrategy = new EmployeeWithDependentFetchingStrategy();
}
这样,Repository到底要执行何种查询就不是由Service和Repository层所抉择了,而是由外面的Aspect抉择,纵使增加了新的业务也无需修改底层处事和Repository层。抉择执行何种查询的逻辑就成为一个横切存眷点了,它被放在Aspect中。Aspect会按照业务法则的差异在Service层挪用Repository层的API之前将抓取计策注入到Repository中。这样我们就可以利用沟通的Service和 Repository层API来满意各类差异的业务法则了。
来看个详细示例吧,该示例会同时抓取一个employee的Department和Dependent的具体信息。我们需要对业务层举办一些改观,增加一个要领:getEmployeeWithDepartmentAndDependentsDetails(int employeeId)。实现新的抓取计策类EmployeeWithDepartmentAndDependentFetchingStaratergy,后者又实现了EmployeeFetchingStrategy并重写了queryEmployeeById要领,该要了解返回优化后的查询,可以在一个SQL语句中获取所需数据。
由Aspect将上述的抓取计策注入到相关的业务中,如下所示:
pointcut empWithDependentAndDepartmentDetail(): call(* EmployeeRepository.findEmployeeById(int))

&& cflow(execution(* EmployeeDetailsService.getEmployeeWithDepartmentAndDependentsDetails(int)));
before(EmployeeRepositoryImpl r): empWithDependentAndDepartmentDetail() && target(r) {
r.fetchingStrategy = new EmployeeWithDepartmentAndDependentFetchingStaratergy();
}
如你所见,我们并没有修改底层业务与Repository层而是利用Aspect和一个新的FetchingStrategy实现就完成了上述新增的业务。
#p#分页标题#e#
此刻我们来谈谈关于二级缓存的查询优化问题。在上面的示例代码中,我们对department实体举办一些修改并设置在二级缓存中。假如对 department实体采纳预先抓取,那么对付同样的department实例,纵使它位于二级缓存中,每次也都需要查询数据库。假如不在查询中获取 department实体,那么业务层就需要参加到事务傍边,因为我们并没有将department实体缓存起来而是通过延迟加载的方法获得它。
这样,事务声明就从底层移到了业务层,固然我们知道该业务需要哪些数据,但O/R Mapping东西却没有提供相应的机制来办理上面碰着的问题,即预先抓取缓存中的数据。
对付那些没有缓存的数据来说这种方法没什么问题,但对付缓存数据来说,这就依赖于O/R Mapping东西了,因为只有它才气办理缓存数据问题。
该示例附带的源代码具体表明白抓取计策。该zip文件含有一个工程示例,叙述了上面谈到的所有场景。你可以利用任何IDE或是利用aspectj编译器从呼吁行执行代码。在执行前请确保jdbc.properties文件与你呆板上的信息一致并建设示例应用所需的表。
你可以利用Eclipse IDE以及AJDT插件运行代码,请凭据下面的步调举办:
解压缩下载好的代码并将工程导入到Eclipse中。
设置Resources/dbscript目次下的jdbc.properties文件中的数据库信息。
完成上面的步调后请执行resources\dbscript\tables.sql剧本,这将建设该示例应用所需的表。
以AspectJ/Java应用的方法运行Main.java文件来建设默认数据并测试上面的抓取计策实现。
结论
本文先容了如何通过差异的抓取计策从后端系统中获取数据,这是以模块化的方法按照业务需求实现的,同时又不会导致底层处事或Repository层太过膨胀。
关于作者:Manjunath R Naganna今朝供职于阿尔卡特朗讯公司,接受高级软件工程师一职,尤其专注基于Java/J2EE的企业应用设计与实现。他感乐趣的规模包罗 Spring Framework、规模驱动设计、事件驱动架构以及面向方面的编程。对付Hemraj Rao Surlu对本文所做的编辑与排版事情,Manjunath表达了本身的谢意,同时他也很感激本身的率领Ramana与Saurabh Sharma在百忙之中抽出时间对本文举办审阅并提出许多重要的反馈信息。
