副标题#e#
这个月,我着手撰写一篇文章,阐明一个写得很糟糕的微评测。究竟,我们 的措施员一直受机能困扰,我们也都想相识我们编写、利用或品评的代码的机能 特征。当我偶尔间写到机能这个主题时,我常常获得这样的电子邮件:“我写的 这个措施显示,动态 frosternation 要比静态 blestification 快,与您上一 篇的概念相反!”很多随这类电子邮件而来的所谓“评测“措施,可能它们运行 的方法,明明表示出他们对付 JVM 执行字节码的实际方法缺乏根基认识。所以 ,在我着手撰写这样一篇文章(将在将来的专栏中颁发)之前,我们先来看看 JVM 幕后的对象。领略动态编译和优化,是领略如何区分微评测优劣的要害(不 幸的是,好的微评测很少)。
动态编译简史
Java 应用措施的编译进程与静态编译语言(譬喻 C 或 C++)差异。静态编 译器直接把源代码转换成可以直接在方针平台上执行的呆板代码,差异的硬件平 台要求差异的编译器。Java 编译器把 Java 源代码转换成可移植的 JVM 字节 码,所谓字节码指的是 JVM 的“虚拟呆板指令”。与静态编译器差异,javac 险些不做什么优化 —— 在静态编译语言中该当由编译器举办的优化事情,在 Java 中是在措施执行的时候,由运行时执行。
第一代 JVM 完全是表明的。JVM 表明字节码,而不是把字节码编译成呆板码 并直接执行呆板码。虽然,这种技能不会提供最好的机能,因为系统在执行表明 器上耗费的时间,比在需要运行的措施上耗费的时间还要多。
即时编译
对付证实观念的实现来说,表明是符合的,可是早期的 JVM 由于太慢,迅速 得到了一个坏名声。下一代 JVM 利用即时 (JIT) 编译器来提高执行速度。凭据 严格的界说,基于 JIT 的虚拟机在执行之前,把所有字节码转换成呆板码,但 是以惰性方法来做这项事情:JIT 只有在确定某个代码路径将要执行的时候,才 编译这个代码路径(因此有了名称“ 即时 编译”)。这个技能使措施能启动得 更快,因为在开始执行之前,不需要冗长的编译阶段。
JIT 技能看起来很有前途,可是它有一些不敷。JIT 消除了表明的承担(以 特另外启动本钱为价钱),可是由于若干原因,代码的优化品级仍然是一般般。为了制止 Java 应用措施严重的启动延迟,JIT 编译器必需很是迅速,这意味着 它无法把大量时间花在优化上。所以,早期的 JIT 编译器在举办内联假设 (inlining assumption)方面较量守旧,因为它们不知道后头大概要装入哪个类 。
固然从技能上讲,基于 JIT 的虚拟机在执行字节码之前,要先编译字节码, 可是 JIT 这个术语凡是被用来暗示任何把字节码转换成呆板码的动态编译进程 —— 纵然那些可以或许表明字节码的进程也算。
HotSpot 动态编译
HotSpot 执行进程组合了编译、机能阐明以及动态编译。它没有把所有要执 行的字节码转换成呆板码,而是先以表明器的方法运行,只编译“热门”代码 —— 执行得最频繁的代码。当 HotSpot 执行时,会汇集机能阐明数据,用来决 定哪个代码段执行得足够频繁,值得编译。只编译执行最频繁的代码有几项机能 优势:没有把时间挥霍在编译那些不常常执行的代码上;这样,编译器就可以花 更多时间来优化热门代码路径,因为它知道在这上面花的时间物有所值。并且, 通过延迟编译,编译器可以会识趣能阐明数据,并用这些数据来改造优化决定, 譬喻是否需要内联某个要领挪用。
为了让工作变得更巨大,HotSpot 提供了两个编译器:客户机编译器和处事 器编译器。默认回收客户机编译器;在启动 JVM 时,您可以指定 -server 开关 ,选择处事器编译器。处事器编译器针对最大峰值操纵速度举办了优化,合用于 需要恒久运行的处事器应用措施。客户机编译器的优化方针,是淘汰应用措施的 启动时间和内存耗损,优化的庞洪水平远远低于处事器编译器,因此需要的编译 时间也更少。
HotSpot 处事器编译器可以或许执行各类样的类。它可以或许执行很多静态编译器中 常见的尺度优化,譬喻代码晋升( hoisting)、民众的子表达式排除、轮回展开 (unrolling)、范畴检测排除、死代码排除、数据流阐明,尚有各类在静态编译 语言中不实用的优化技能,譬喻虚要领挪用的聚合内联。
#p#副标题#e#
一连从头编译
HotSpot 技能另一个有趣的方面是:编译不是一个全有可能全无(all-or- nothing)的命题。在表明代码路径必然次数之后,会把它从头编译成呆板码。但 是 JVM 会继承举办机能阐明,并且假如认为代码路径出格热门,可能将来的性 能阐明数据认为存在特另外优化大概,那么尚有大概用更高一级的优化从头编译 代码。JVM 在一个应用措施的执行进程中,大概会把沟通的字节码从头编译很多 次。为了深入相识编译器做了什么,请用 -XX:+PrintCompilation 符号挪用 JVM,这个符号会使编译器(客户机或处事器)每次运行的时候打印一条短动静 。
栈上(On-stack)替换
#p#分页标题#e#
HotSpot 开始的版本编译的时候每次编译一个要领。假如某个要领的累计执 行次数高出指定的轮回迭代次数(在 HotSpot 的第一版中,是 10,000 次), 那么这个要领就被看成热门要领,计较的方法是:为每个要领关联一个计数器, 每次执行一个后向分支时,就会递增计数器一次。可是,在要领编译之后,要领 挪用并没有切换到编译的版本,需要退出并从头进入要领,后续挪用才会利用编 译的版本。功效就是,在某些环境下,大概永远不会用到编译的版本,譬喻对付 计较麋集型措施,在这类措施中所有的计较都是在要领的一次挪用中完成的。重 量级要领大概被编译,可是编译的代码永远用不到。
HotSpot 最近的版本回收了称为 栈上(on-stack)替换 (OSR) 的技能,支持 在轮回进程中间,从表明执行切换到编译的代码(可能从编译代码的一个版本切 换到另一个版本)。
那么,这与评测有什么干系?
我向您许诺了一篇关于评测和机能丈量的文章,可是迄今为止,您获得的只 是汗青的教导和 Sun 的 HotSpot 白皮书的老调重谈。绕这么大的圈子的原因是 ,假如不领略动态编译的进程,就不行能正确地编写或表明 Java 类的机能测试 。(纵然深入领略动态编译和 JVM 优化,也仍然长短常坚苦的。)
为 Java 代码编写微评测远比为 C 代码编写可贵多
判定要领 A 是否比要领 B 更快的传统要领,是编写小的评测措施,凡是叫 做 微评测。这个趋势很是有意义。科学的要领不能缺少独立的观测。妖怪总在 细节之中。为动态编译的语言编写并表明评测,远比为静态编译的语言可贵多。为了相识某个布局的机能,编写一个利用该布局的措施一点也没有错,可是在许 多环境下,用 Java 编写的微评测汇报您的,往往与您所认为的纷歧样。
利用 C 措施时,您甚至不消运行它,就能相识很多措施大概的机能特征。只 要看看编译出的呆板码就可以了。编译器生成的指令就是将要执行的呆板码,一 般环境下,可以很公道地领略它们的时间特征。(有很多有短处的例子,因为总 是漏掉分支预测或缓存,所以机能差的水平远远高出查察呆板码所可以或许想像的程 度,可是大大都环境下,您都可以通过查察呆板码相识 C 措施的机能的许多方 面。)
假如编译器认为某段代码不得当,筹备把它优化掉(凡是的环境是,评测到 它实际上不做任何工作),那么您在生成的呆板码中可以看到这个优化 —— 代 码不在那儿了。凡是,对付 C 代码,您不必执行很长时间,就可以对它的机能 做出公道的揣度。
而在另一方面,HotSpot JIT 在措施运行时会一连地把 Java 字节码从头编 译成呆板码,而从头编译触发的次数无法预期,触发从头编译的依据是机能阐明 数据积聚到必然数量、装入新类,可能执行到的代码路径的类已经装入,可是还 没有执行过。一连的从头编译环境下的时间丈量会很是杂乱、让人误解,并且要 想得到有用的机能数据,凡是必需让 Java 代码运行相当长的时间(我曾经看到 过一些怪事,在措施启动运行之后要加快几个小时甚至数天),才气得到有用的 机能数据。
排除死代码
编写好评测的一个挑战就是,优化编译器要擅长找出死代码 —— 对付措施 执行的输出没有浸染的代码。可是评测措施一般不发生任何输出,这就意味着有 一些,可能全部代码都有大概被优化掉,而毫蒙昧觉,这时您实际丈量的执行要 少于您设想的数量。详细来说,很多微评测在用 -server 方法运行时,要比用 -client 方法运行时好得多,这不是因为处事器编译器更快(固然处事器编译器 一般更快),而是因为处事器编译器更擅长优化掉死代码。不幸的是,可以或许让您 的评测事情很是短(大概会把评测完全优化掉)的死代码优化,在处理惩罚实际做些 事情的代码时,做得就不会那么好了。
奇怪的功效
清单 1 的评测包括一个什么也不做的代码块,它是从一个测试并发线程机能 的评测中摘出来的,可是它实际丈量的基础不是要评测的对象。
清单 1. 被料想之外的死代码弄乱的评测
#p#分页标题#e#
public class StupidThreadTest {

   public static void doSomeStuff() {

     double uselessSum = 0;

     for (int i=0; i<1000; i++) {

       for (int j=0;j<1000; j++) {

         uselessSum += (double) i + (double) j;

       }

     }

   }

   public static void main(String[] args) throws InterruptedException {

     doSomeStuff();
int nThreads = Integer.parseInt(args[0]);
Thread[] threads = new Thread[nThreads];
for (int i=0; i<nThreads; i++)
threads[i] = new Thread(new Runnable() {
public void run() { doSomeStuff(); }
});
long start = System.currentTimeMillis();
for (int i = 0; i < threads.length; i++)
threads[i].start();
for (int i = 0; i < threads.length; i++)
threads[i].join();
long end = System.currentTimeMillis();
System.out.println("Time: " + (end-start) + "ms");
}
}
外貌上看, doSomeStuff() 要领可以给线程分点事做,所以我们可以或许从 StupidThreadBenchmark 的运行时间推导出多线程调治开支的一些环境。可是, 因为 uselessSum 从没被用过,所以编译器可以或许判定出 doSomeStuff 中的全部 代码是死的,然后把它们全部优化掉。一旦轮回中的代码消失,轮回也就消失了 ,只留下一个空空如也的 doSomeStuff。表 1 显示了利用客户机和处事器方法 执行 StupidThreadBenchmark 的机能。两个 JVM 运行大量线程的时候,都表示 出差不多是线性的运行时间,这个功效很容易被误解为处事器 JVM 比客户机 JVM 快 40 倍。而实际上,是处事器编译器做了更多优化,发明整个 doSomeStuff 是死代码。固然确实有很多措施在处事器 JVM 上会提速,可是您 在这里看到的提速仅仅代表一个写得糟糕的评测,而不能成为处事器 JVM 机能 的证明。可是假如您没有细看,就很容易会把两者夹杂。
表 1. 在客户机和处事器 JVM 中 StupidThreadBenchmark 的机能
| 线程数量 | 客户机 JVM 运行时间 | 处事器 JVM 运行时间 |
| 10 | 43 | 2 |
| 100 | 435 | 10 |
| 1000 | 4142 | 80 |
| 10000 | 42402 | 1060 |
对付评测静态编译语言来说,处理惩罚过于努力的死代码排除也是一个问题。但 是,在静态编译语言中,可以或许更容易地发明编译器排除了大块评测。您可以查察 生成的呆板码,查察是否漏了某块措施。而对付动态编译语言,这些信息不太容 易会见获得。
预热
假如您想丈量 X 的机能,一般环境下您是想丈量它编译后的机能,而不是它 的表明机能(您想知道 X 在赛场上能跑多快)。要做到这样,需要“预热” JVM —— 即让方针操纵执行足够的时间,这样编译器在为执行计时之前,就有 足够的运行表明的代码,并用编译的代码替换表明代码。
利用早期 JIT 和没有栈上替换的动态编译器,有一个容易的公式可以丈量方 法编译后的机能:运行多次挪用,启动计时器,然后执行若干次要领。假如预热 挪用高出要领被编译的阈值,那么实际计时的挪用就有大概全部是编译代码执行 的时间,所有的编译开支该当在开始计时之前产生。
而利用本日的动态编译器,工作更坚苦。编译器运行的次数很难预测,JVM 凭据本身的想法从表明代码切换到编译代码,并且在运行期间,沟通的代码路径 大概编译、从头编译不止一次。假如您不处理惩罚这些事件的计时问题,那么它们会 严重歪曲您的计时功效。
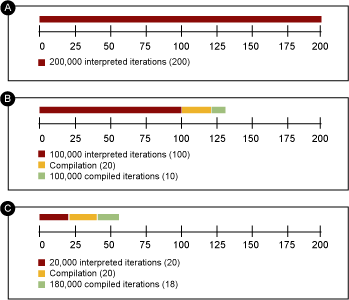
图 1 显示了由于估量不到的动态编译而造成的大概的计时歪曲。假设您正在 通过轮回计时 200,000 次迭代,编译代码比表明代码快 10 倍。假如编译只在 200,000 次迭代时才产生,那么您丈量的只是表明代码的机能(时间线(a))。假如编译在 100,000 次迭代时产生,那么您总共的运行时间是运行 200,000 次 表明迭代的时间,加上编译时间(编译时间非您所愿),加上执行 100,000 次 编译迭代的时间(时间线(b))。假如编译在 20,000 次迭代时产生,那么总时 间会是 20,000 次表明迭代,加上编译时间,再加上 180,000 次编译迭代(时 间线(c))。因为您不知道编译器什么时候执行,也不知道要执行多长时间,所 以您可以看到,您的丈量大概受到严重的歪曲。按照编译时间和编译代码比表明 代码快的水平,纵然对迭代数量只做很小的变革,也大概造成丈量的“机能”有 极大差别。
图 1. 因为动态编译计时造成的机能丈量歪曲
#p#分页标题#e#
那么,到底几多预热才足够呢?您不知道。您能做到的最好的,就是用 – XX:+PrintCompilation 开关来运行评测,调查什么造成编译器事情,然后改变 评测措施的布局,以确保编译在您启动计时之前产生,在计时轮回进程中不会再 产生编译。
不要健忘垃圾收集
那么,您已经看到,假如您想获得正确的计时功效,就必需要让被测代码比 您想像的多运行屡次,以便让 JVM 预热。另一方面,假如测试代码要举办工具 分派事情(差不多所有的代码都要这样),那么垃圾收集器也必定会运行。这是 会严重歪曲计时功效的另一个因素 —— 纵然对迭代数量只做很小的变革,也意 味着没有垃圾收集和有垃圾收集之间的区别,就会偏离“每迭代时间”的丈量。
假如用 -verbose:gc 开关运行评测,您可以看到在垃圾收集上淹灭了几多时 间,并相应地调解您的计时数据。更好一些的话,您可以长时间运行您的措施, 这可以担保触发很多垃圾收集,从而更准确地分摊垃圾收集的本钱。
动态反优化(deoptimization)
很多尺度的优化只能在“根基块”内执行,所以内联要领挪用对付到达好的 优化凡是很重要。通过内联要领挪用,不只要领挪用的开支被排除,并且给优化 器提供了更大的优化块可以优化,会带来相当大的死代码优化时机。
清单 2 显示了一个通过内联实现的这类优化的示例。outer() 要领用参数 null 挪用 inner(),功效是 inner() 什么也不做。可是通过把 inner() 的调 用内联,编译器可以发明 inner() 的 else 分支是死的,因此可以或许把测试和 else 分支优化掉,在某种水平上,它甚至能把整个对 inner() 的挪用全优化掉 。假如 inner() 没有被内联,那么这个优化是不行能产生的。
清单 2. 内联如何带来更好的死代码优化
public class Inline {

  public final void inner(String s) {

   if (s == null)

    return;

   else {

    // do something really complicated

   }

  }

  public void outer() {

   String s=null;

   inner(s);

  }

}
可是不利便的是,虚要领对内联造成了障碍,而虚函数挪用在 Java 中要比 在 C++ 中普遍。假设编译器正试图优化以下代码中对 doSomething() 的挪用:
 Foo foo = getFoo();

  foo.doSomething();
从这个代码片段中,编译器没有须要分清要执行哪个版本的 doSomething() —— 是在类 Foo 中实现的版本,照旧在 Foo 的子类中实现的版本?只在少数 环境下谜底才明明 —— 譬喻 Foo 是 final 的,可能 doSomething() 在 Foo 中被界说为 final 要领 —— 可是在大都环境下,编译器不得不揣摩。对付每 次只编译一个类的静态编译器,我们很幸运。可是动态编译器可以利用全局信息 举办更好的决定。假设有一个还没有装入的类,它扩展了应用措施中的 Foo。现 在的情景更像是 doSomething() 是 Foo 中的 final 要领 —— 编译器可以把 虚要领挪用转换成一个直接分派(已经是个改造了),并且,还可以内联 doSomething()。(把虚要领挪用转换成直接要领挪用,叫做 单形 (monomorphic)挪用调动。)
请稍等 —— 类可以动态装入。假如编译器举办了这样的优化,然后装入了 一个扩展了 Foo 的类,会产生什么?更糟的是,假如这是在工场要领 getFoo() 内举办的会怎么样? getFoo() 会返回新的 Foo 子类的实例?那么,生成的代 码不就无效了么?对,是无效了。可是 JVM 能指出这个错误,并按照今朝无效 的假设,打消生成的代码,并规复表明(可能从头编译不正确的代码路径)。
功效就是,编译器要举办主动的内联决定,才气获得更高的机能,然后当这 些决定依据的假设不再有效时,就会收回这些决定。实际上,这个优化如此有效 ,乃至于给那些不被包围的要领添加 final 要害字(一种机能能力,在以前的 文章中发起过)对付提高实际机能没有太大浸染。
奇怪的功效
清单 3 中包括一个代码模式,个中组合了不起当的预热、单形挪用调动以及 反优化,因今生成的功效毫无意义,并且容易被误解:
清单 3. 测试措施的功效被单形挪用调动和后续的反优化歪曲
#p#分页标题#e#
public class StupidMathTest {

   public interface Operator {

     public double operate(double d);

   }

   public static class SimpleAdder implements Operator {

     public double operate(double d) {

       return d + 1.0;

     }

   }

   public static class DoubleAdder implements Operator {

     public double operate(double d) {

       return d + 0.5 + 0.5;

     }

   }

   public static class RoundaboutAdder implements Operator {

     public double operate(double d) {

       return d + 2.0 - 1.0;

     }

   }

   public static void runABunch(Operator op) {

     long start = System.currentTimeMillis();

     double d = 0.0;

     for (int i = 0; i < 5000000; i++)

       d = op.operate(d);

     long end = System.currentTimeMillis();

     System.out.println("Time: " + (end-start) + "  ignore:" + d);

   }

   public static void main(String[] args) {

     Operator ra = new RoundaboutAdder();

     runABunch(ra); // misguided warmup attempt

     runABunch(ra);

     Operator sa = new SimpleAdder();

     Operator da = new DoubleAdder();

     runABunch(sa);

     runABunch(da);

   }

}
StupidMathTest 首先试图做些预热(没有乐成),然后丈量 SimpleAdder、 DoubleAdder、 RoundaboutAdder 的运行时间,功效如表 2 所示。看起来仿佛 先加 1,再加 2 ,然后再减 1 最快。加两次 0.5 比加 1 还快。这有大概么? (谜底是:不行能。)
表 2. StupidMathTest 毫无意义且令人误解的功效
| 要领 | 运行时间 |
| SimpleAdder | 88ms |
| DoubleAdder | 76ms |
| RoundaboutAdder | 14ms |
这里产生什么呢?在预热轮回之后, RoundaboutAdder和runABunch() 确实 已经被编译了,并且编译器 Operator和RoundaboutAdder 长举办了单形挪用转 换,第一轮运行得很是快。而在第二轮( SimpleAdder)中,编译器不得不反优化 ,又退回虚函数分派之中,所以第二轮的执行表示得更慢,因为不能把虚函数调 用优化掉,把时间花在了从头编译上。在第三轮( DoubleAdder)中,从头编译比 第二轮少,所以运行得就更快。(在现实中,编译器会在 RoundaboutAdder和 DoubleAdder 长举办常数替换(constant folding),生成与 SimpleAdder 险些 沟通的代码。所以假如在运行时间上有差别,那么不是因为算术代码)。哪个代 码首先执行,哪个代码就会最快。
那么,从这个“评测”中,我们能得出什么结论呢?实际上,除了评测动态 编译语言要比您大概想到的要微妙得多之外,什么也没获得。
竣事语
这个示例中的功效错得如此明明,所以很清楚,必定产生了什么,可是更小 的功效可以或许很容易地歪曲您的机能测试措施的功效,却不会触发您的“这里必定 有什么对象有问题”的鉴戒。固然本文列出的这些内容是微评测歪曲的一般来历 ,可是尚有很多其他来历。本文的中心思想是:您正在丈量的,凡是不是您觉得 您正在丈量的。实际上,您凡是所丈量的,不是您觉得您正在丈量的。对付那些 没有包括什么实际的措施负荷,测试时间不足长的机能测试的功效,必然要很是 当心。
