新浪微博如火如荼,基于微博的各类应用也层出不穷。有一种共鸣好像是:微博数据蕴含着富厚的信息,加以适当的挖掘,可以或许实现浩瀚贸易应用。刚好社会网络阐明也是我之前有所相识并一连进修的一个规模,因此我做了微博数据阐明方面的一些实验。这些实验是较量劈头的,属于摸索性的阶段,虽然不能跟微博阐明家这样较量成熟的应用相提并论。而且我的阐明根基上都出于想虽然的直觉感觉,没有详细的理论支撑,这方面需要试着找点书籍来阅读一下,貌似有蛮多可以参考的。
一、用R登录并宣布微博
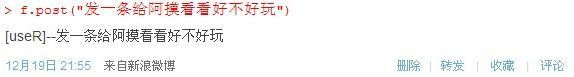
之所以仍然选择用R来做这个登录和宣布的事情,是思量到阐明进程的持续性,究竟可以或许在同一个平台下面完成所有的事情,照旧很令人身心愉悦的。这里借助了一款呼吁行欣赏器cURL,这个欣赏器在R中可以用RCurl实现,简朴的先容发起参考medo的《R好逸恶劳之RCurl》。由于我对HTTP这些对象都属于低级未入门程度,没能实现直接的登录,只好操作了cookie实现间接登录。可是最终功效照旧蛮不变的。编写这个登录和宣布微博的函数,目标之一是为后续的数据收罗做筹备,但同时也可以或许实现同步更新差异平台信息的成果,譬喻写一条语句就可以或许把人人状态、新浪微博、飞信签名等等同步更新,照旧很有趣的。只是人人状态和飞信签名貌似不是很不变,偶然能用偶然报错,我稍微测试了一下,大概是cookie的问题,今朝没有深入摸索。
(更新:今朝已经实现了直接登录,这样或者可以绕过cookie的问题。)
总地来说这个成果的结果就是这个样子。
二、收罗存眷信息,建造粉丝及存眷人的地域漫衍
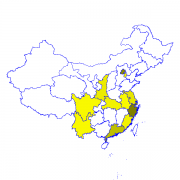
在登录之后,就可以用一些轮回语句来收罗存眷者与被存眷者的ID等信息(不知道这算不算是某种爬虫)。为了描写地域漫衍,只需要收罗用户的地域信息就OK了。然后借助maptools包,可以较量利便地画出简朴的用户漫衍图。这里没步伐画外洋人士,留情。
我的粉丝的漫衍:
我存眷的人的漫衍:
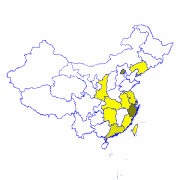
可以看得出来,岂论是存眷照旧被存眷,用户的漫衍都算是较量会合。这个很可以领略,因为我是小网虫一只,没啥遍及的人气,哈哈。可是显然地,某省ID的频数很高,令人欣慰。
三、收罗存眷信息,建造存眷干系的网络图
这个事情今朝尚未完成,主要是碰着了技能性的障碍:矩阵太大,我的计较机算不动。事实上,收罗数据的进程跟上述的地理位置的收罗没有本质区别,都是一些轮回的计较,最终获得的功效是这个样子:
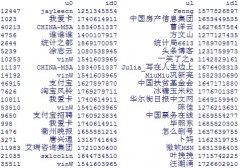
前两列是我存眷的用户以及他们的ID,后两列是前两列所存眷的用户及ID。这个数据集今朝有22446行,涉及到15868个用户ID,假如要画网络图,好像对计较机的机能有较量高的要求。所以我只好临时选择了一种无奈的步伐:抽样。获得的功效或许是这样:
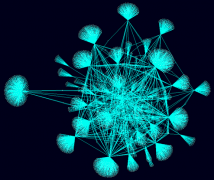
换一种抽样的逻辑,淘汰工具个数,可以做出相对清晰一点的网络。像是这样:
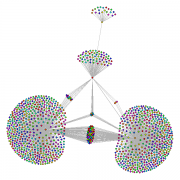
固然作图碰着了必然的障碍,可是在做的进程中我照旧有所体会:follow的信息比fans的信息更清洁一点。因为我都是以我的ID为中心出发来举办数据的收罗,所以本质上获得的网络都是个别网。而fans的干系往往不能说明什么问题,因为我的许多fans都是不知所云的fans。我臆测,这些fans,要么是所谓的僵尸ID,要么是所谓的告白ID,要么就是一些新用户随便添加的存眷。这些存眷干系并不是我所体贴的干系,固然他在某种水平上浮现着我的某种中心度。因此我在后头把体贴的重点会合在我的follow上,因为由我出发的这条follow存眷链是较量纯粹的:要么是感乐趣的人,要么是有情感的人,总之都是具有确实意义的存眷干系。
四、基于follow干系的一种用户推荐
意识到follow干系的纯粹性之后,我就开始试图针对follow干系做一些阐明。最先想到的就是用户的推荐。
我没有详细研究新浪微博今朝利用的用户推荐的方法,感受是有两种:按照小我私家资料推荐,按照小我私家标签推荐。
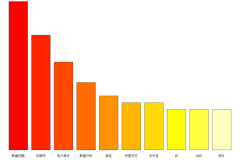
我的直观领略,推荐系统的一个逻辑问题是:用户会接管奈何的推荐。可能换句话说,用户是为什么而去存眷他人的。因此我就以为,基于小我私家资料的推荐大概并不是那么靠谱,尤其是新浪微博一连不绝地向我推荐”浙江大学“的用户。且不说内里有许多是”浙江大学都市学院“之类的丧家之犬,要害是我为什么仅仅因为他跟我同一所大学结业就要去存眷他呢?我以为根基上没有原理。除非在大学的基本上还可以或许举办其他判定,较准确地揣度出他跟我大概是本科室友,那我就较量感激新浪微博了哈哈。至于按照小我私家标签来举办推荐,我以为对我来说相对还算靠谱,因为我主要照旧按照乐趣喜好来举办存眷的。可是仅仅按照小我私家的标签来做推荐,又有点单调与单方面,我以为插手”存眷工具的标签“大概会更完善一点。这种思量的来历是:我存眷的那些人都是我确实感乐趣的那些人,他们大概会拥有一些雷同的标签,而这些标签是我没有给本身加的,这要么是因为懒,要么是因为没有意识到。于是我收罗了我follow的那些用户的小我私家标签,然后做了简朴的频数统计,获得了下面的功效,这个功效根基上算是一目了然。
别的一种大概靠谱的推荐是直接从存眷干系出发举办推荐。这种思量的来历是:我存眷的那些人都是我确实感乐趣的那些人,他们大概会拥有一些配合的存眷工具,而这些工具是我还没有存眷的,这要么是因为懒,要么是因为没有意识到。于是我画了这样的图:
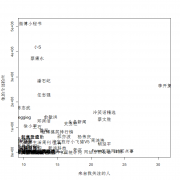
在这个图内里标出了一些用户,横轴暗示我存眷的人傍边有几多人正在存眷这个用户,纵轴暗示这个用户自己的粉丝数量。横轴这个数值越大,说明我存眷的人傍边有很大一部门正在存眷这个用户,譬喻李开复老师,于是我就很大概对李开复老师是感乐趣的。之所以要思量纵轴(用户自己的粉丝数量),是因为有一些用户的粉丝自己就许多,譬喻潘石屹等人,他们是某种明星人物,因此我存眷的人傍边有许多都存眷这个用户,是一种很正常的追星现象,未必可以或许很好地浮现这种存眷乐趣的会合性与通报性。基于这种思量,我配置了一个明星阈值:粉丝数量大于10000的,认为是某种明星,临时不思量作为推荐(或者可以在某种topN的推荐中呈现)。这样处理惩罚的功效是:
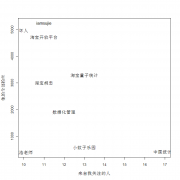
可以看出来,这种做法的本质是把原图的左下角放大了。
另一种计策是将上面原图的横轴和纵轴数据做整合,用横轴除以纵轴,结构一个比例:我存眷的人在他全部粉丝中的占比。可以很直观地领略,假如一个用户的粉丝自己就不多,而个中就有许多几何是我所存眷的人,那么这个用户很大概也是我会感乐趣的用户。
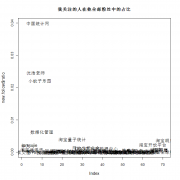
这个图做得有点粗拙,其实横轴可以把”来自我存眷的人“加进去,但好像也不很影响功效的直观性,就懒得从头画了。
尚有一种较量雷同的思路:已存眷我 & 我未存眷 & 我存眷的人傍边有人已存眷他。
根基就是这样,这是我对微博阐明的一些劈头实验,应该会继承进修下去。
本文转自:http://www.itongji.cn/DataAnalysis/030X2R012.html
